AI資料在「本地處理」 就代表完全不會跨境或被保存嗎?
AI服務開始進入企業之後,「資料放在哪裡」愈來愈常出現在採購、法遵與資訊部門的討論裡。AWS近日宣布,Amazon Bedrock上的部分Claude模型可以在印度境內進行跨區域推論,企業從孟買或海德拉巴送出的請求,會留在印度境內的AWS區域之間處理,不會因為運算需求再送往其他國家。對金融、醫療、政府或有資料落地要求的企業來說,這類設計當然很重要。但真正值得注意的是,「資料在哪裡處理」其實只回答了資料生命週期中的其中一段。
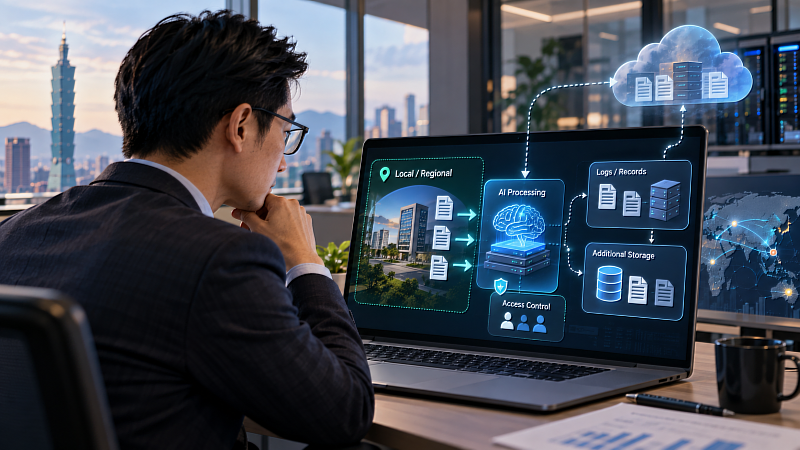
(中央社財經訊息服務20261007 12:16:20)AI服務開始進入企業之後,「資料放在哪裡」愈來愈常出現在採購、法遵與資訊部門的討論裡。AWS近日宣布,Amazon Bedrock上的部分Claude模型可以在印度境內進行跨區域推論,企業從孟買或海德拉巴送出的請求,會留在印度境內的AWS區域之間處理,不會因為運算需求再送往其他國家。對金融、醫療、政府或有資料落地要求的企業來說,這類設計當然很重要。但真正值得注意的是,「資料在哪裡處理」其實只回答了資料生命週期中的其中一段。
「本地處理」、「不拿來訓練模型」或「零資料保留」各別的意思是:「本地處理」是在說資料在哪裡進行運算;「不拿來訓練」是在說內容會不會被拿去改善模型;「不保存」則是在說AI處理完之後,輸入與輸出會不會留下來;這三件事彼此相關,但不能互相取代。
以這次AWS的設計來說,Claude的推論可以限制在印度境內進行,AWS也說明模型輸入與輸出預設不會被保存,也不會提供給模型供應商拿去訓練。但企業自己仍然可能留下資料。例如為了除錯、稽核或監控,企業可能開啟模型呼叫日誌,把AI的請求、回覆或相關紀錄寫進CloudWatch Logs或S3。這些紀錄對管理很有幫助,但也代表原本「AI沒有保存」的內容,可能因為企業自己的設定,又在另一個地方留下副本。
有時候供應商確實沒有保存你的內容,但系統日誌保存了;有時候主要資料留在本地,監控紀錄卻放在另一個區域;有時候模型本身不拿資料訓練,外部整合工具卻可能有自己的保存規則。所以企業真正需要看的,是整條資料到底怎麼流動。
一份文件送進AI之後,從哪個區域進入、在哪裡處理、處理後有沒有留下紀錄、哪些人可以存取、多久會刪除,這些事情加起來,才是真正的資料治理。這個觀念放在現在特別重要,因為企業使用AI的資料已經不只是一般提問。可能是客戶資料、內部文件、合約、財務資訊、會議內容,甚至公司自己累積多年的知識庫。如果只看到「資料本地化」四個字就認為風險已經解決,反而很容易忽略後面的日誌、備份、權限與刪除問題。
企業採購AI服務時,至少應該把幾件事情問清楚:資料實際在哪裡處理、輸入輸出會不會保存、系統日誌記錄什麼、哪些人或服務可以存取,以及服務停用後資料怎麼刪除。
不是每家公司都需要最嚴格的資料落地要求,也不是所有AI資料都一樣敏感。但企業至少要知道自己的資料從進入AI,到最後被刪除,中間到底經過哪些地方。了解透過AI處理的這份資料從進去到消失,中間到底發生了什麼事。
【匯智生活觀察室】 從生活出發,觀察科技與數位時代的大小事,分享實用資訊,讓科技更貼近日常。 由Cloudmax匯智資訊策劃,持續關注科技、資安與數位生活議題。 官方網站:www.cloudmax.com.tw
圖片來源:Cloudmax 匯智/AI生成
企業導入AI時,「資料在本地處理」只是其中一個條件。資料送進AI後,還可能涉及日誌、備份、權限與其他儲存位置;真正需要確認的,是資料在哪裡處理、是否留下紀錄、誰能存取,以及最後如何刪除。看懂整條資料流,才比只看到「本地處理」四個字更接近真正的資料安全。